11 Ekim 2026
Düşük Güçlü AI Hızlandırıcıları ve FPGA'ler: Apex Compute Unified Engine
edge-ai · fpga · ai-hizlandirici · dusuk-guc · olcumler
Her edge AI üreticisi bir TOPS sayısı yazar. Neredeyse hiçbiri token başına joule sayısı yazmaz. Bu bir sorundur; çünkü bir insansız hava aracı, bir robot kolu ya da bina içindeki bir kutu transformer’ı gerçekten çalıştırdığında, sistemin çalışıp çalışmayacağını belirleyen iki sayı enerji/verim ve gecikmedir — veri sayfasındaki tepe değer değil.
Apex Compute’a (2024’te kurulmuş, Los Altos merkezli) bu pencereden bakıyorum. Unified Engine adını verdikleri, transformer’a odaklanan bir AI hızlandırıcısı geliştiriyorlar. Bugün hazır FPGA’lar üzerinde çalışıyor; 12nm ASIC şerit-çıkışı devam ediyor. İddiaları alışılmadık kadar spesifik — ve GitHub’da yeniden üretilebilir. Öyleyse iddiaları ölçelim.
FPGA’ler neden hâlâ edge’te önemli?
Edge hızlandırıcı pazarı kalabalık: sabit fonksiyonlu ASIC’ler (Hailo, Axelera, SiMa.ai), uygulama işlemcilerine gömülü NPU’lar, minik nöromorfik çipler ve FPGA’ler. FPGA’lerin kendine özgü bir yeri var:
- Yeniden yapılandırılabilirlik. Veri yolu üretimden sonra yeniden programlanabilir. Bir model ailesi kaydığında — CNN’lerden transformer’lara olduğu gibi, şimdi de VLA (görüntü-dil-eylem) mimarilerine — FPGA değiştirmek yerine yeniden optimize edilebilir.
- Silikon öncesi doğrulama. Özel silikon şeride çıkaran bir girişim için gerçek RTL’i FPGA kumaşında çalıştırmak, maskelere milyonlar harcamadan hata bulmanın yoludur.
- Deterministik gecikme. Planlayıcı sürprizi yok, GPU sürücü yığınıyla paylaşılan önbellek yok. Robotik ve araç kontrol döngüleri için sınırlı gecikme bir özelliktir.
Klasik itiraz — FPGA’ler ASIC’lere göre yavaş ve güç oburudur — gerçektir. Tam da bu yüzden “333 MHz’teki tek bir FPGA motoru, satıştaki 8nm ASIC’lerle yarışır” iddiası dikkatli bir bakışı hak ediyor.
Unified Engine’in içinde
Apex’in tasarım tezi basit: transformer’lar genel matris makineleri değildir. Dar bir operatör kümesidir — matmul, softmax, eleman bazlı işlemler, kuantize dikkat (attention) — binlerce kez tekrarlanan. Bu yüzden Unified Engine, matris ve vektör yollarını birleştiren tek bir hesap motorudur; bu operatörler genel amaçlı bir boru hattından sıkıştırılmak yerine tepe verimliliğe yakın çalışacak şekilde tasarlanmıştır.
Xilinx Kintex UltraScale+ (KU5P) üzerindeki yayımlanmış FPGA prototipi şunları bildiriyor:
| Metrik | Prototip değeri |
|---|---|
| Lojik ayak izi | 78.348 CLB LUT, 50.045 register |
| DSP dilimi | 197 |
| Çip üstü bellek | 1,05 MB SRAM (30 URAM / 16 BRAM) |
| Zamanlama kapanışı | 366 MHz, 16nm kumaş |
| Tepe hesaplama | 47 GFLOPS BF16 |
| Matris kullanımı | tepe değerin %95,6’sına kadar |
| Hassasiyet biçimleri | BF16, FP8, INT8, INT4, FP4, blok-kuantize TQ4 |
İki detay öne çıkıyor. Birincisi kullanım oranı: M=K=N=1024 matmul’da teorik tepe değerin %95’i (42 GFLOPS’tan 40,17) mükemmeldir; çoğu FPGA hızlandırıcısı bellekte takıldığı için %30–60 aralığında yaşar. İkincisi birleştirilmiş çekirdekler: dikkat çekirdeği Q·Kᵀ, ölçekleme, bias, softmax ve değer matmul’ını tek geçişte çalıştırır — 3072 dizi uzunluğunda 36,87 GFLOPS tepe, teorik değerin %87,8’i. Birleştirdiğiniz her çekirdek, ödemediğiniz bir DRAM gidiş-dönüşüdür; edge’te watt’lar tam oraya gider.

Ölçümler: Gemma 3 1B, başa baş
Manşet karşılaştırması, edge AI için varsayılan referans kart olan NVIDIA Jetson Orin Nano 8GB’ye karşı. Apex, Gemma 3 1B kod-çözümünü llama.cpp ile (CUDA, Jetson’da tek CPU iş parçacığı) çalıştırdı:
| Apex · Kintex KU5P | Jetson Orin Nano | |
|---|---|---|
| Süreç | 16nm FPGA kumaşı | 8nm ASIC |
| Bellek | 32-bit DDR4 @ 1333 MHz | 128-bit LPDDR5 @ 2133 MHz |
| Güç | toplam 4,5 W | yalnızca hesap modülü 7 W |
| Kod-çözme hızı | 15,63 token/sn | 7,59 token/sn |
| Token başına enerji | 0,287 J | 0,922 J |
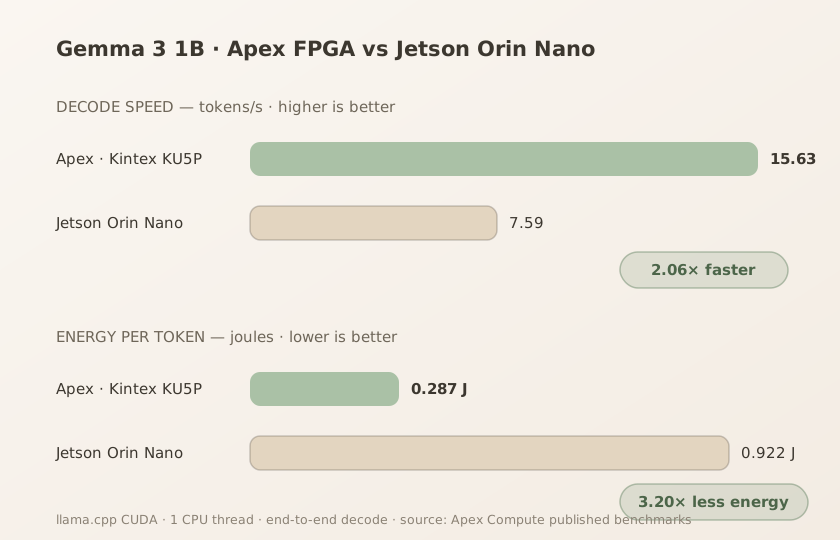
Bu, 2,06× daha hızlı kod-çözme ve 3,20× daha iyi token başına enerji demek — üstelik üçte bir bellek bant genişliğiyle, daha eski bir süreç düğümünde. Operatör bazlı döküm kazancın nereden geldiğini açıklıyor: RMSNorm 27×, RoPE 6,75×, attention içi bileşenler 20×’e kadar, büyük matris-vektör çarpımları CUDA’ya göre 3,12×. Softmax, eleman bazlı işlemler ve normalizasyonlar tam olarak GPU’ların watt başına en kötü olduğu işlemlerdir — ve transformer kod-çözümü bunlardan oluşur.
Kalibrasyon için: aynı model Jetson üzerinde PyTorch CUDA ile 2,9 token/sn yapıyor — Apex motoru bunun 5,2× katı hızlı. Karşılaştırma bir yönden adil (her ikisi de uçtan uca, llama.cpp en iyi pratik CUDA yığını) ve diğer yönden kaba (bir 16nm FPGA’nın enerjide 8nm ASIC’i geçmesi bir mimari zaferidir, süreç zaferi değil).
Satıştaki edge ASIC’lerine karşı
Daha ilginç çerçeve, bugün satın alabileceğiniz hızlandırıcı modüllerine göre normalize edilmiş verim (Llama 3.2 1B / Gemma 3 1B / Gemma 4 E2B):
| Platform | Tür | Normalize verim |
|---|---|---|
| NVIDIA Jetson Orin Nano | 8nm ASIC, satışta | 1× |
| Axelera Metis AIPU | 4 çekirdek @ 800 MHz, satışta | 2,2× |
| SiMa.ai Modalix | MLSoC, satışta | 2,4× |
| Apex Unified Engine | 1 motor @ 333 MHz, FPGA | 2× |
| Apex 12nm ASIC (projeksiyon) | 32 motor @ 1,6 GHz | 20× |
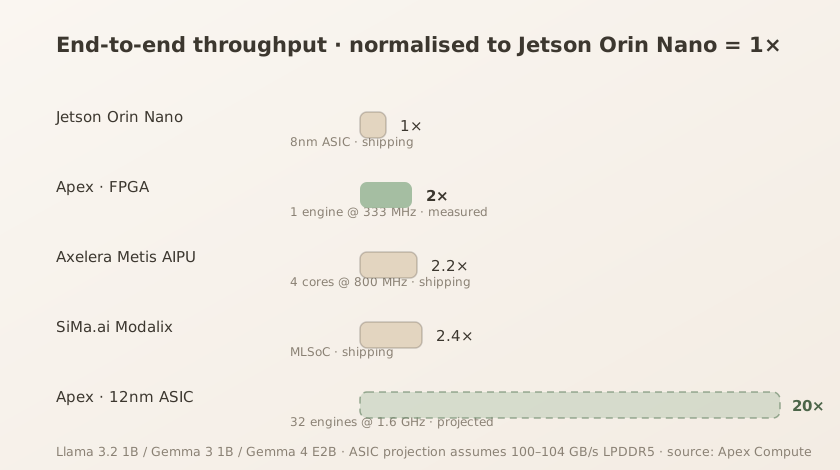
Saat hızı üçte bir olan tek bir Apex motoru, Axelera’nın uçtan uca veriminin ~%90’ına ve SiMa.ai’ninkinin ~%82’sine ulaşıyor. Bunu dikkatle okuyun: mimarinin saat başına veriminin yüksek olduğunu söylüyor, ayrıca FPGA prototipinin henüz satıştaki silikonu açıkça geçmediğini de. 20× iddiası ASIC projeksiyonunda yaşıyor — projeksiyonlar ise dürüst mühendisliğin dipnot gerektirdiği yerlerdir.
12nm yol haritası — ve nasıl okunmalı
Apex’in ikinci aşaması, MIPS’in sistem mimarisi ortağı olduğu GlobalFoundries 12nm edge-AI SoC’su: 1,6 GHz’te 32 motor, ~104 GB/s LPDDR5, hedef 10 W’ın altında. Projekte edilen sistem hızlanması Jetson’a göre ≥20×.
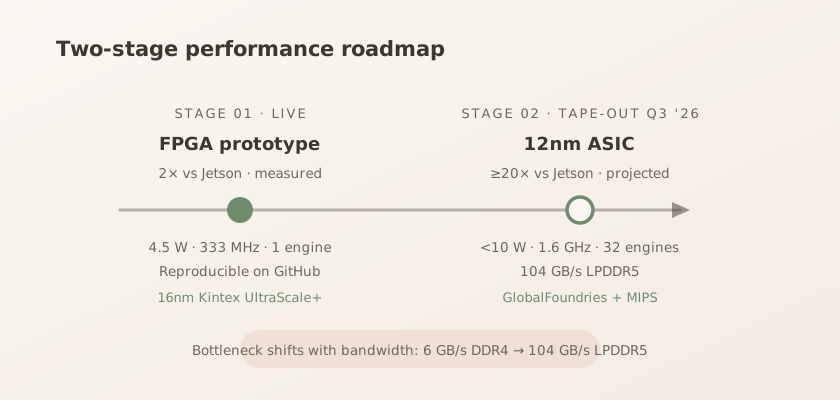
Projekte edilmiş bir sayı nasıl okunur? Belirttikleri kısıtlara bakın. Apex açık: tasarım ağırlık matmul’unda bellek-bant genişliği sınırlı, SRAM’de oturan işlemlerde hesap sınırlı; arada yapısal bir darboğaz yok. Bir simülasyonu yayımlamanın doğru yolu budur — darboğazı adlandırın. 12nm motoru mevcut DDR4 kurulumunun 10× bant genişliğini varsayar; LPDDR5 teslimatı düşerse projeksiyon da düşer. FPGA sayılarının arkasındaki iki motorlu, 6 GB/s DDR senaryosu herkese açık depolarından yeniden üretilebilir; bu, çoğu üreticinin sunduğundan daha fazla şeffaflıktır.
Yazılım donanımın yarısıdır
Edge hızlandırıcıları silikondan çok yazılımdan ölür. Apex’in yazılım yığınında not edilmesi gereken üç pragmatik seçim var:
- Derlenen tek bir prefill programı 192 tokene kadar her isteği işler; talimat ikilisi ~10× küçülür. Gönderilecek daha az ikili, doğrulanacak daha az ikili.
- Blok başına kuantizasyon: INT4 veya NVFP4, 64 elemanlı K-bloğu başına MSE en aza indirilerek seçilir; normlar ve gömmeler BF16’da kalır. 4-bit çıkarımı 8-bit doğrulukta gösteren hile budur — toleransın olduğu yeri kuantize edin, tekdüze değil.
- Yeniden başlatmasız saha güncellemeleri: tek komut kumaşı yeniden flaşlar, sıcak açılış yapar ve PCIe’yi yeniden tarar. Üretim filolarında “güç çevrimi yok” hafife alınan bir özelliktir.
Metin, görüntü, konuşma ve konumlandırma modellerinin (Qwen, Llama, Gemma, VLA iş yükleri) otomatik test paketi altında prototipte çalıştığı bildiriliyor.
Bunun önemli olduğu yerler
Belirtilen hedefler — insansız hava araçları, otonom araçlar, robotik, bina-dışı (off-cloud) kurulumlar — tasarruf edilen bir joule’un uçuş süresi veya batarya ömrü olduğu, verinin binadan çıkamadığı yerlerdir. Uzay aracına bitişik yerleşik ve uzak hesaplama için aynı denklem daha acımasız bir sabitle geçerlidir: her watt, bir yerde reddetmeniz gereken termal bütçedir.
Herhangi bir düşük güçlü hızlandırıcıyı değerlendirme listesi
Edge çıkarım donanımı karşılaştırıyorsanız — Apex ya da başkası — şunları ölçün, bu sırayla:
- Token başına joule (veya çerçeve başına) — kendi modelinizde, uçtan uca; çekirdek tepe değerleri değil.
- Operatör karışımınızdaki kullanım yüzdesi. Matmul’da %60’ın altı veri yolunun takıldığı anlamına gelir.
- Sayıların ne varsaydığı — bellek bant genişliği, yığın boyutu, hassasiyet, kuantizasyon şeması.
- Yeniden üretilebilirlik — depo var mı? Yeniden çalıştırabilir misiniz?
- Güncelleme yolu — dağıtılmış bin cihaz yeni bir modeli nasıl alır? Aynı alışkanlık, ev sunucusunun zaman içinde güvende kalmasını belirler. Altı aylık kaçırılmış güncellemenin bedelini Kurup Bırakılan Sistemler yazısında çıkardım.
SSS
LLM çıkarımı için FPGA gerçekten GPU’dan verimli mi? Edge’te yığın boyutu 1 transformer kod-çözme için — softmax, RMSNorm ve küçük matvec’lerin baskın olduğu yerde — özelleşmiş bir veri yolu, Apex’in Jetson Orin Nano’ya karşı 3,2× enerji avantajında görüldüğü gibi, watt başına genel bir GPU’yu geçebilir. Büyük yığınlı eğitim için GPU’lar hâlâ rakipsizdir.
Blok-kuantize TQ4/INT4 nedir? Bütün bir tensörü tek ölçekle kuantize etmek yerine, donanım blok başına (Apex: 64 elemanlı K-bloğu) yeniden yapılandırma hatasını en aza indirerek hassasiyet seçer. Doğruluk korunurken bellek trafiği düşer.
20× ASIC projeksiyonu bir şey kanıtlıyor mu? Bant genişliği ölçeklendiğinde mimarinin ölçeklendiğini kanıtlıyor. Dürüst sinyal, FPGA prototipinin ölçülmüş 2×’i ve adlandırılmış darboğazlarıdır. 20×’i sonuç değil, şerit-çıkış tarihli (3Ç 2026) bir hipotez olarak ele alın.
Ölçümleri kendim doğrulayabilir miyim? Evet — RTL, çalışma zamanı ve Gemma 3 1B örneği GitHub’da herkese açıktır (apex-compute/unified-engine) ve FPGA prototip kartı lisanslanabilir. Yeniden üretilebilirlik, bu pazardaki tek en iyi güvenilirlik sinyalidir.
Edge ürünüm için FPGA mı ASIC mi? Model karışımınız 18 ay içinde değişecekse — VLA ve çok-modlu momentum göz önüne alınırsa muhtemel — FPGA veya yeniden yapılandırılabilir IP sigorta satın alır. İş yükü donmuşsa ve hacim yüksekse ASIC maliyet ve güçte kazanır.
Bu yazıdaki performans sayıları Apex Compute’un yayımlanmış değerleridir (apexcompute.com), aksi belirtilmedikçe uçtan uca ölçülmüştür; projeksiyonlar açıkça işaretlenmiştir. Bir tasarımı onaylamadan önce kendi modeliniz ve güç zarfınızla yeniden ölçün.